
Aprenda a otimizar o uso do Claude da Anthropic, economizar tokens e evitar atingir o limite de contexto ou estourar o orçamento da API
Se você utiliza o Claude (seja nos planos Pro/Team da Anthropic ou consumindo via API/Claude Code), com certeza já se deparou com a temida mensagem de limite de mensagens atingido ou tomou um susto ao ver a velocidade com que seus créditos evaporam.
O modelo da Anthropic — especialmente o Claude 3.5 Sonnet — é hoje uma das ferramentas mais poderosas do mercado para programação, análise de dados e redação de alto nível. No entanto, sua janela de contexto generosa pode ser uma faca de dois gumes: quanto mais dados você joga para o modelo processar a cada rodada, mais tokens de entrada (input) você queima.
A boa notícia é que com alguns ajustes simples na forma como você estrutura prompts e arquivos, é possível reduzir drasticamente o consumo de tokens sem perder nada em precisão ou qualidade.
Abaixo, separei 5 estratégias essenciais para você aplicar hoje mesmo no seu fluxo de trabalho.
Como funciona o consumo de tokens no Claude?
Leia mais -.> Veja como comprar um notebook para trabalhar com marketing digital
Antes das dicas, vale entender uma regra básica: a cada nova mensagem dentro do mesmo chat, o Claude relê todo o histórico da conversa.
Isso significa que, se você anexou um documento grande na primeira mensagem e continuou batendo papo no mesmo chat por 10 respostas, aquele documento foi faturado ou contabilizado contra a sua cota 10 vezes consecutivas.
Entendido isso, veja como estancar esse vazamento de contexto.
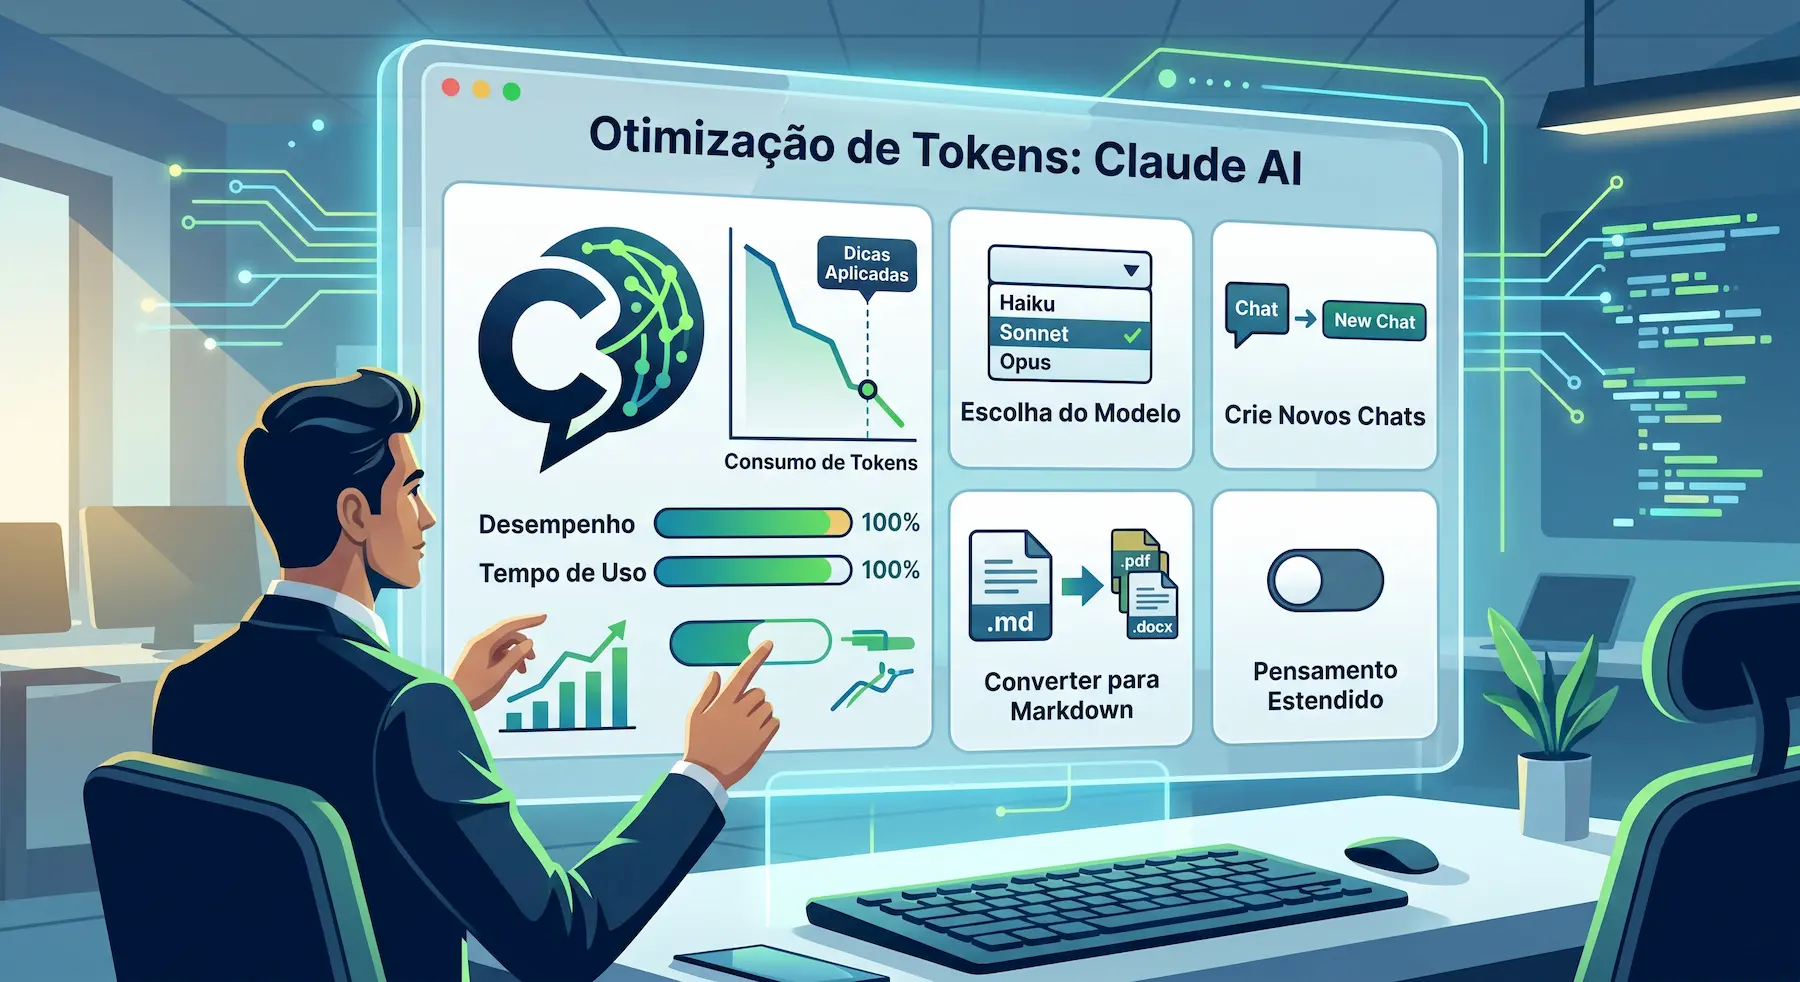
1. Converta PDFs e planilhas pesadas para Markdown (.md)
PDFs, planilhas Excel (.xlsx) e documentos Word carregam uma quantidade enorme de metadados, formatações ocultas, tabelas desnecessárias e códigos de renderização que consomem tokens preciosos sem agregar valor semântico.
- O erro comum: Subir um PDF de 40 páginas ou um relatório cheio de gráficos diretamente no Claude.
- A solução inteligente: Converta previamente o conteúdo relevante para Markdown (
.md) ou texto puro (.txt).
O formato Markdown mantém títulos (#, ##), listas e tabelas simplificadas, eliminando toda a “gordura” de formatação. Ferramentas gratuitas de conversão (ou scripts simples em Python) conseguem reduzir em até 60% a 70% o tamanho em tokens do mesmo documento.
2. Inicie novos chats para tarefas ou fases diferentes
Um dos hábitos mais caros ao usar IAs é manter conversas infinitas.
Quando você continua discutindo um projeto no mesmo chat após horas de trabalho, o Claude precisa carregar centenas de mensagens anteriores como contexto a cada comando, inflando os tokens de input.
- Evite o efeito bola de neve: Se você usou o Claude para planejar uma estratégia e agora vai para a fase de execução, encerre o chat antigo.
- Boas práticas: Peça para o próprio Claude: “Faça um resumo executivo em tópicos com as decisões tomadas até aqui”. Copie esse resumo, abra um novo chat e comece a nova etapa com a memória limpa e o contexto enxuto.
3. Seja cirúrgico no contexto: passe apenas o que a IA precisa ver
Alimentar a IA com informação em excesso não apenas queima tokens, mas também aumenta as chances de alucinação e perda de foco (needle in a haystack).
- Recorte seletivo: Em vez de enviar uma base de dados inteira com 50.000 linhas, envie apenas um recorte de 5 a 10 linhas como exemplo de estrutura e explique a lógica.
- No código: Se você precisa corrigir uma função específica de 20 linhas, não cole o arquivo com 1.500 linhas de código. Envie a função problemática e apenas as interfaces ou dependências imediatas.
4. Otimize os Prompts do Sistema e evite redundâncias
Muitas vezes, construímos prompts gigantescos repetindo regras de formatação, personas exageradas e instruções negativas desnecessárias.
- Economia semântica: Em vez de escrever instruções longas como:
“Por favor, você poderia agir como um consultor sênior de marketing e me dar uma resposta muito detalhada, evitando enrolação e garantindo que…”
- Seja direto e imperativo:
“Atue como especialista em marketing. Entregue: análise de concorrência e 3 planos de ação em tópicos.”
Adotar uma engenharia de prompt estruturada (usando tags XML como <contexto>, <tarefa> e <regras>, que o Claude interpreta com máxima eficiência) reduz o número de palavras e deixa a resposta do modelo mais direta, poupando tokens de entrada e de saída.
5. Use ferramentas de automação e pré-processamento local
Se você utiliza o Claude integrado a fluxos de trabalho (n8n, Make, scripts de automação ou terminal com Claude Code):
- Faça o filtro antes da IA: Utilize ferramentas locais ou scripts regex simples para limpar logs, quebras de linha e dados irrelevantes antes de enviar a requisição para a API.
- Utilize Prompt Caching (se usar API): Se você precisa repetir uma base de conhecimento fixa em várias consultas, ative o recurso de Cache de Prompt da Anthropic. Ele permite reaproveitar o contexto pré-carregado com até 90% de desconto no custo por token.
Conclusão: Eficiência é a chave para escalar com IA
Inteligência Artificial de ponta não precisa significar custos descontrolados ou bloqueios constantes por limite de uso. A maior parte do desperdício de tokens vem de arquivos desformatados e conversas longas demais.
Ao transformar PDFs em Markdown, segmentar conversas em etapas lógicas e fornecer apenas o contexto estritamente necessário, você ganha duas vezes: economiza tempo/dinheiro e obtém respostas muito mais precisas e rápidas do Claude.
E você?
Já atingiu o limite do Claude no meio de um projeto importante? Qual dessas estratégias você vai aplicar primeiro no seu dia a dia? Deixe seu comentário abaixo!
Refrencias – Youtube canal gestor tech